星颖资源网

 找回密码
 立即注册
查看: 48|回复: 0

从模型量化到服务部署:使用 LLM Compressor 实现 Qwen3-8B 的高效推理优化-demo-附整

[复制链接]

7万

主题

1万

回帖

26万

积分

管理员

Rank: 9Rank: 9Rank: 9

积分
266020
发表于 2025-9-30 10:00:09 | 显示全部楼层 |阅读模式
项目地址:llm-compressor GitHub (https://github.com/vllm-project/llm-compressor)
官方文档:LLM Compressor Docs (https://blog.vllm.ai/llm-compressor/main/getting-started/)
随着大语言模型参数规模不断增长,部署成本与运行开销也水涨船高。LLM Compressor 提供了灵活的量化方案,可以大幅降低模型的推理延迟与资源占用。本篇博客将以 Qwen3-8B 模型为例,详细介绍如何使用 llm-compressor 完成模型量化并基于 vLLM 启动 API 服务。
(https://linux.do#p-9072857-h-1)

项目结构概览
model_quantization/
├── config/               # 配置文件目录
│  ├── quant_config.yaml        # 量化任务总配置
│  ├── recipe_w8a16_group_quant.yaml  # 量化策略定义(W8A16 示例)
├── dataset/              # 校准数据存放目录
├── model/               # 原始模型存放路径
├── run.py               # 量化执行入口脚本
├── README.md              # 项目说明文档
(https://linux.do#p-9072857-h-2)

使用前准备
(https://linux.do#p-9072857-h-1-3)1. 编写配置文件
你需要在 config/quant_config.yaml 中配置如下内容:
model: TinyLlama/TinyLlama-1.1B-Chat-v1.0    # 模型路径(支持 HuggingFace ID 或本地路径)
dataset_id: HuggingFaceH4/ultrachat_200k    # 校准数据集 ID(用于量化校准)
recipe: recipe_w4a16_group_quant_asym_awq.yaml # 量化策略文件路径
max_sequence_length: 2048            # 模型最大输入 token 长度
num_calibration_samples: 2000          # 校准样本数(越多精度越高)
save_dir: temp                 # 量化模型保存路径
(https://linux.do#p-9072857-h-2-recipe-recipe_w8a16_group_quantyaml-4)2. 编写量化 recipe 文件(例如:recipe_w8a16_group_quant.yaml)
quant_stage:
 quant_modifiers:
  QuantizationModifier:
   ignore: [lm_head]       # 忽略输出层,避免影响生成质量
   config_groups:
    group_0:
     weights:
      num_bits: 8       # 权重量化为 8-bit 整数
      type: int
      symmetric: true
      strategy: group
      group_size: 128
     activations:
      num_bits: 16       # 激活值采用 16-bit float 精度
      type: float
     targets: [Linear]     # 仅量化线性层
(https://linux.do#p-9072857-qwen3-8b-w8a16-5)

Qwen3-8B 模型量化实战(W8A16)
(https://linux.do#p-9072857-step-1-6)Step

:下载模型到本地
pip install modelscope -i https://mirrors.tuna.tsinghua.edu.cn/pypi/web/simple
cd model/
modelscope download --model Qwen/Qwen3-8B --local_dir ./Qwen/Qwen3-8B
(https://linux.do#p-9072857-step-2-7)Step

:安装依赖并执行量化
pip install llmcompressor -i https://mirrors.tuna.tsinghua.edu.cn/pypi/web/simple
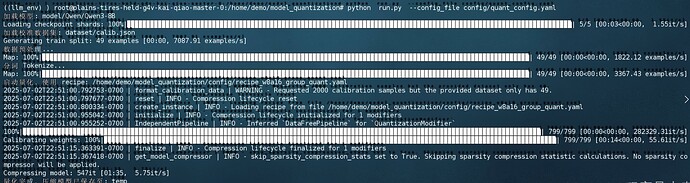
python run.py --config_file config/quant_config.yaml
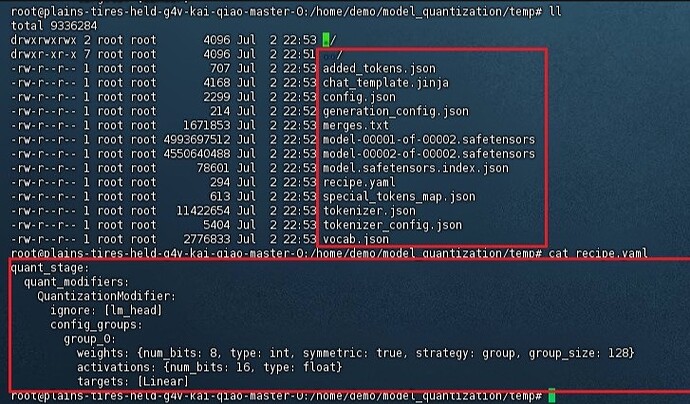
成功后,量化模型将保存在 temp/ 目录中。


(https://linux.do#p-9072857-vllm-8)

使用 vLLM 启动量化模型服务
(https://linux.do#p-9072857-step-3-vllm-9)Step

:安装 vLLM 并启动服务
pip install vllm -i https://mirrors.tuna.tsinghua.edu.cn/pypi/web/simple
python3 -m vllm.entrypoints.openai.api_server \
 --host 0.0.0.0 \
 --served-model-name test_qianwen3_w8a16 \
 --model temp \
 --dtype float16 \
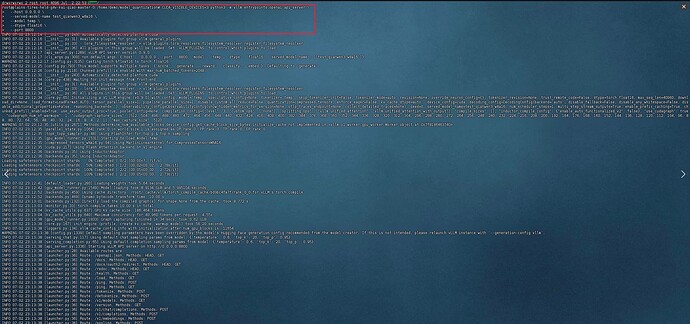
 --port 8800
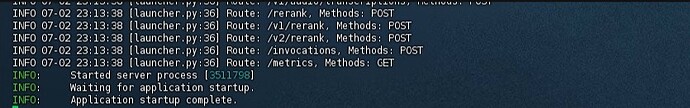
服务启动效果截图:
(https://linux.do#p-9072857-api-10)

API 测试:快速验证量化效果
通过 curl 命令发起一个简单的推理请求:
curl -X POST http://localhost:8800/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{
  "model": "test_qianwen3_w8a16",
  "messages": [
   {"role": "user", "content": "请介绍一下人工智能"}
  ],
  "temperature": 0.7,
  "max_tokens": 100
 }'
示例响应截图:


下载地址:
游客,如果您要查看本帖隐藏内容请回复
回复

使用道具 举报

您需要登录后才可以回帖 登录 | 立即注册

本版积分规则

微信

社群

VIP

AI

顶部

QQ|本站内容来源网友投稿或网络转载,如果有侵权的内容,请联系我们删除。|小黑屋|人人为我,我为人人!| 星颖资源网

GMT+8, 2026-11-19 17:58 , Processed in 0.053964 second(s), 22 queries .

快速回复 返回顶部 返回列表